Python 拉 A 股历史数据:两个现行免费接口的可运行代码,和复权口径差 1.42% 的实测
本文目录(8 节)
这类文章最大的问题是接口早就停了、文章还挂着。所以下面两段代码是 2026 年 9 月 12 日在本机实际执行过、确认返回了数据的版本,连返回的字段名和第一行数值都贴出来了。两个接口都不需要注册、不需要 token、不需要积分。先给代码,再说最容易出事的复权口径。
一、接口一:AKShare
安装:pip install akshare。实测版本 1.18.56。
import akshare as ak

df = ak.stock_zh_a_hist(
    symbol="600519",          # 六位代码,不带交易所前缀
    period="daily",           # daily / weekly / monthly
    start_date="20240101",    # 八位数字,不带横杠
    end_date="20240131",
    adjust="qfq",             # qfq 前复权 / hfq 后复权 / 空字符串 不复权
)
print(df.shape)
print(df.head(3).to_string())
实测返回 22 行 12 列,列名是中文:日期、股票代码、开盘、收盘、最高、最低、成交量、成交额、振幅、涨跌幅、涨跌额、换手率。第一行(2024-01-02,前复权)开盘 1580.66,收盘 1550.67,成交量 32156。
成交量的单位是手,不是股。 这一点后面会再提一次。
AKShare 的数据来自公开财经网站,所以它有一个特性:上游网站改版或者限流的时候,接口会临时失效。 实测过程中就遇到了连续请求之后被拒绝的情况。生产环境里必须带重试:
import akshare as ak
import time

def fetch_daily(symbol, start, end, adjust="hfq", retries=5, wait=3):
    for i in range(retries):
        try:
            return ak.stock_zh_a_hist(symbol=symbol, period="daily",
                                      start_date=start, end_date=end,
                                      adjust=adjust)
        except Exception as e:
            print(f"第 {i+1} 次失败:{type(e).__name__}")
            time.sleep(wait)
    raise RuntimeError(f"{symbol} 拉取失败")

df = fetch_daily("600519", "20240101", "20241231")批量拉数据时一定要加间隔,连续几百次高频请求会被上游拒绝,间隔 0.5 到 1 秒是比较安全的起点。
二、接口二:Baostock
安装:pip install baostock。同样不需要注册。
import baostock as bs
import pandas as pd

lg = bs.login()
print("login:", lg.error_code, lg.error_msg)      # 实测返回 0 success

rs = bs.query_history_k_data_plus(
    "sh.600519",                                   # 必须带 sh. 或 sz. 前缀
    "date,code,open,high,low,close,volume,amount,turn,pctChg",
    start_date="2024-01-01",                       # 带横杠,和 AKShare 不一样
    end_date="2024-01-31",
    frequency="d",                                 # d 日 / w 周 / m 月 / 5,15,30,60 分钟
    adjustflag="2",                                # 1 后复权 / 2 前复权 / 3 不复权
)

rows = []
while (rs.error_code == "0") and rs.next():
    rows.append(rs.get_row_data())

df = pd.DataFrame(rows, columns=rs.fields)
bs.logout()
print(df.shape)
print(df.head(3).to_string())
实测返回 22 行 10 列。注意三个坑: 返回的所有字段都是字符串,要自己转成数值;adjustflag 的取值是 1 后复权、2 前复权、3 不复权,和直觉相反,很容易记错;拉完一定要 logout(),否则会话会挂着。
三、实测发现:同一天,两个源差 1.42%
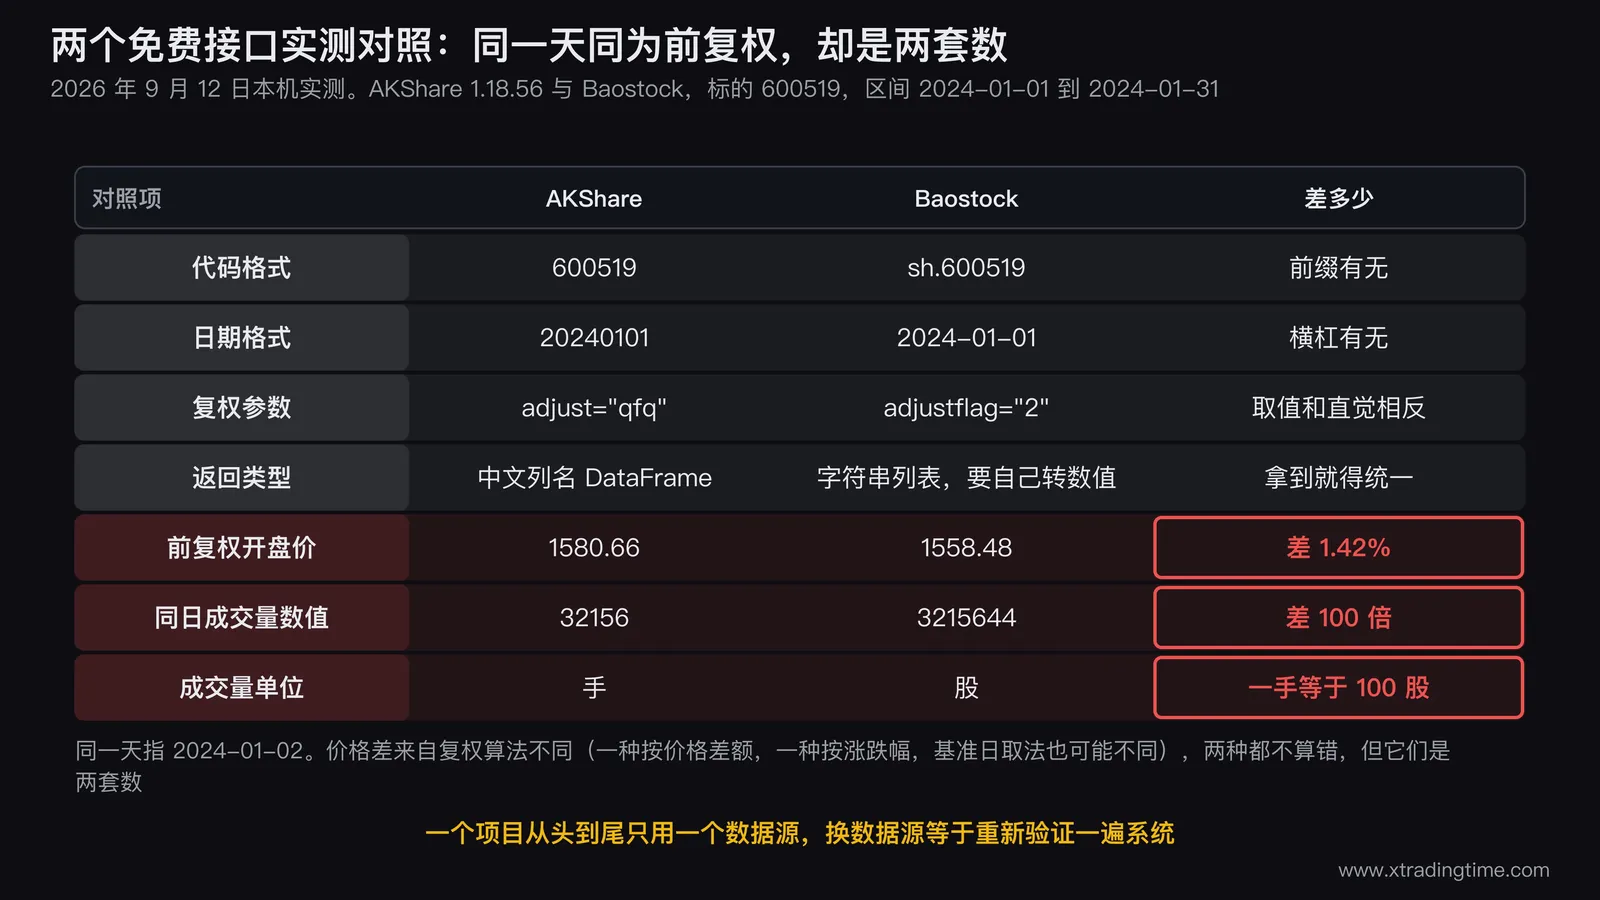
这是这篇最想提醒的一件事。同一只股票、同一天、两个接口都设成前复权,结果是这样:
| 接口 | 2024-01-02 开盘价 | 成交量数值 | 成交量单位 |
|---|---|---|---|
| AKShare(adjust=“qfq”) | 1580.66 | 32156 | 手 |
| Baostock(adjustflag=“2”) | 1558.48 | 3215644 | 股 |
价格差 1.42%,成交量数值差 100 倍。
价格差来自复权算法不同:一种按价格差额复权,一种按涨跌幅复权,前复权的基准日取法也可能不同。两种都不算错,但它们是两套数。
成交量差 100 倍来自单位:一手等于 100 股。如果你的策略里有「成交量超过某个绝对值」这类条件,换个数据源结果会完全不同。
得出三条规则:
规则一,一个项目从头到尾只用一个数据源。 混用两个源做同一套统计,结论没有意义。
规则二,拿到数据的第一件事是统一列名和单位。 下面这段做的就是这件事:
def normalize(df, source):
    """把两个源的输出统一成同一套列名和单位(成交量统一为股)"""
    if source == "akshare":
        out = df.rename(columns={
            "日期": "date", "开盘": "open", "最高": "high",
            "最低": "low", "收盘": "close", "成交量": "volume",
        })[["date", "open", "high", "low", "close", "volume"]].copy()
        out["volume"] = out["volume"].astype(float) * 100      # 手转股
    else:  # baostock
        out = df[["date", "open", "high", "low", "close", "volume"]].copy()
        for c in ["open", "high", "low", "close", "volume"]:
            out[c] = out[c].astype(float)
    out["date"] = out["date"].astype(str)
    return out.sort_values("date").reset_index(drop=True)
规则三,换数据源等于重新验证一遍系统。 不要在系统跑着的时候换源。
四、两个接口的限制对照
| 维度 | AKShare | Baostock |
|---|---|---|
| 是否需要注册或 token | 不需要 | 不需要 |
| 覆盖范围 | 极广,股票之外还有期货、宏观、基金等 | 聚焦 A 股行情与基础财务 |
| 最小周期 | 日线之外也支持分钟级 | 支持 5、15、30、60 分钟 |
| 历史长度 | 视上游而定,日线可回溯很长 | 日线可回溯到上世纪九十年代 |
| 频率限制 | 受上游网站限流影响,需自己加间隔和重试 | 相对稳定,仍建议加间隔 |
| 稳定性风险 | 上游网站改版会导致个别接口失效 | 服务器偶有维护窗口 |
| 实时行情 | 有接口,但延迟和口径需自行核实 | 不提供实时 |
| 合规提示 | 数据来自公开网站,商业用途需自行评估 | 同样需自行评估 |
两个都装上,是最省事的容错方案。 理由见下一节。
五、一次真实的停运,和它的教训
2025 年 8 月,另一个被广泛使用的数据服务因为机房代理商与运营商之间的业务纠纷导致服务器被断电,服务中断约五天后才全部恢复。大量依赖单一数据源的量化用户在这五天里拿不到数据。事后该服务改成了双活架构。
这件事的教训不是「哪个数据源更靠谱」,而是:任何免费数据源都可能在你毫无准备的时候消失几天。
对应的做法有三条,做完成本很低:
第一,把历史数据落到本地。 每天增量更新,存成 Parquet 或者 CSV。你的回测应该读本地文件,不应该每次都去请求接口。
第二,两个接口都写好适配函数,主源挂了切备源,第三节那个 normalize 就是为此准备的。
第三,给所有网络请求加超时和重试,失败时写日志而不是静默跳过。静默跳过会让你的数据集悄悄缺几天,而缺的那几天可能正好是大行情。
六、复权三种口径,对回测的影响不一样
这一节决定你的回测结果对不对。
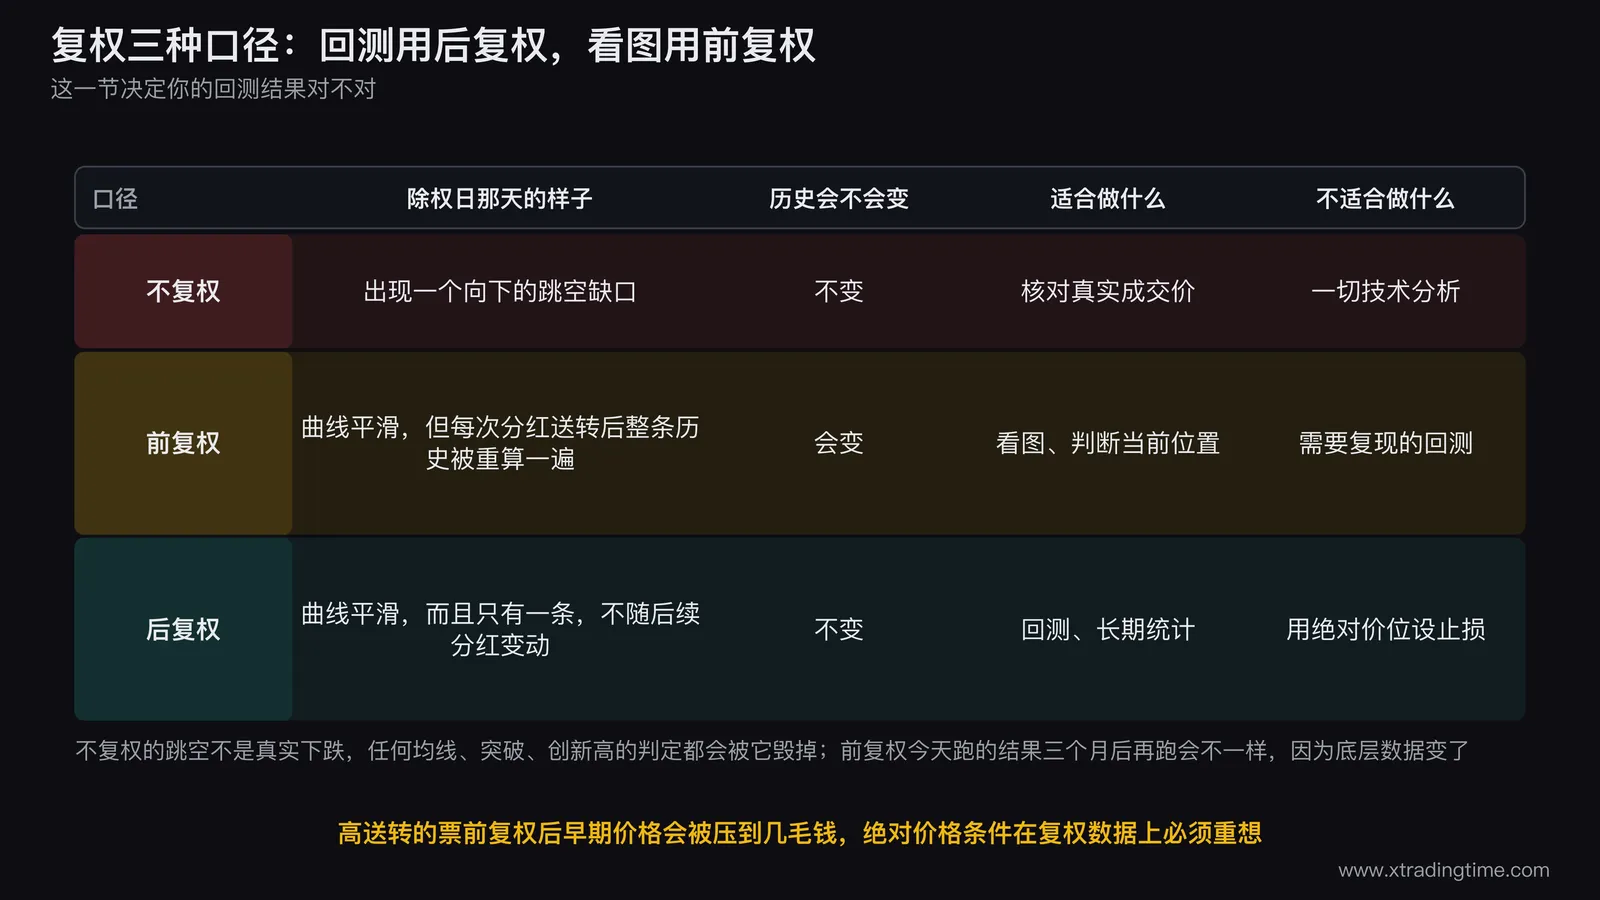
不复权。 除权除息那天价格会出现一个向下的跳空,这个跳空不是真实的下跌。任何均线、突破、创新高的判定都会被它毁掉。回测不要用不复权。
前复权。 把历史价格按现在的价格体系折算,最近的价格等于真实价格,越早的价格失真越多。它有一个关键特性:每次分红送转之后,整条历史价格都会被重算一遍。 也就是说你今天跑出来的回测结果,三个月后再跑一次,数字会不一样,因为底层数据变了。前复权适合看图和判断当前位置,不适合做需要复现的回测。
后复权。 以最早的价格为基准往后累积,早期价格等于真实价格,历史数据不会因为后续分红而变化。回测用后复权。 代价是价格数值会远高于真实价格,所以止损位不要写成绝对价格,要写成百分比或者 ATR 倍数。
| 口径 | 历史会不会变 | 适合做什么 | 不适合做什么 |
|---|---|---|---|
| 不复权 | 不变 | 核对真实成交价 | 一切技术分析 |
| 前复权 | 会变 | 看图、判断当前位置 | 需要复现的回测 |
| 后复权 | 不变 | 回测、长期统计 | 用绝对价位设止损 |
一个常被忽略的细节:高送转的股票,前复权之后早期价格会被压到很低,低到几毛钱的量级。这时候如果你的策略里有「股价低于 5 元不做」这类绝对值条件,回测会把这只票在早期全部排除掉,而实盘当年它并不便宜。凡是用到绝对价格的条件,在复权数据上都要重新想一遍。
这类问题属于回测里最难自己发现的一类,其他几种见回测常见的坑;拿到数据之后怎么组织成交易记录做统计,见Excel 统计交易的公式怎么写。
七、拿到数据之后的三个检查
写完代码先做这三个检查,能挡掉大部分后续的莫名其妙。
检查一,行数对不对。 A 股一年约 240 到 250 个交易日。拉一年拿回来 180 行,说明这只票停过牌或者接口漏了数据。
检查二,有没有重复日期和空值。 df["date"].duplicated().sum() 和 df.isna().sum() 各跑一次,都应该是 0。
检查三,用一只你熟悉的票对一遍。 挑一天,和券商软件上显示的价格核对。对不上先查复权设置,再查单位。
写在最后
这件事真正的难点不在代码,代码就上面那几行。难点在口径:复权用哪一种、单位是手还是股、数据源换了要不要重新验证。这些不对,代码跑得再顺,跑出来的也是错的结论。
给一个起步建议:先用后复权把一只票的十年日线拉下来存成本地文件,用第七节那三个检查过一遍,再去做回测。把数据落地这一步做扎实,后面所有事情都会容易很多。Excel 侧的最简回测框架见用 Excel 做最简回测,不写代码的路径见不写代码能不能做回测。
3秒免费测一下你的”管不住手指数”:journal.xtradingtime.com(记住 3316,就能找到我们)
本文内容仅供教育和参考用途,不构成任何投资建议。交易有风险,入市须谨慎。

在微信里搜「Tom讲交易」即可关注,每周更新交易教学
推荐课程
合约陪跑实战训练营
不只教方法,更带你实盘执行。从仓位管理到止损止盈,手把手纠正你的交易习惯,建立可复制的盈利系统。
相关文章
量化交易入门:散户也能用的 4 大策略框架
量化交易听起来高大上,但 90% 的散户对它的理解还停留在“用程序自动下单”。真正的量化是用数学模型寻找市场规律,把“凭感觉”变成“凭数据”。本文从 0 到 1 拆透量化交易:4 大核心策略框架(趋势跟随/均值回归/统计套利/事件驱动)、散户能用的 5 个量化工具、以及量化 vs 主观交易的本质差异。读完你会知道:量化不是机构专利,散户也能上手。
量化交易回测要用多长时间的数据:先算笔数不算年数,日线策略一年只有 25 笔
「回测一年还是五年」这个问题问错了对象。真正决定回测有没有说服力的是两个数:样本笔数和覆盖的市场状态数。日线策略一年约 250 根 K 线,若平均每 10 根出一个信号,一年只有 25 笔,离 208 笔的显著性门槛差 8.3 年。这篇给出信号密度与所需年数的换算表、五档周期的年信号数对照、市场状态覆盖的三条硬要求,以及数据不够时的三条替代路径。
量化交易不写代码能不能做回测:四条路径的能力边界,加六个选型维度
新手不写代码也能做回测,四条路径各有各的天花板:手工翻图样本上不去、表格法卡在盘中触发顺序、平台内置测试器要写几行脚本、无代码平台上手最快但黑盒最大。这篇给出四条路径的能力对照、六个选型维度(数据与复权、成本设置、出场表达力、能不能导出逐笔明细、样本外支持、可复现性),以及一条和写不写代码无关的硬边界。
量化交易用 Excel 做最简回测:十二列公式跑通一套系统,以及它做不到的三件事
Excel 能做回测,前提是你接受它的边界。这篇给出一个十二列的完整框架,信号、持仓状态、入场价、出场价、R 倍数、累计 R 全部用公式自动算,可以直接粘贴,没有循环引用也不需要宏。同时说清楚 Excel 回测做不到的三件事:盘中触发顺序、滑点与流动性建模、多品种共享资金,以及出现哪四个信号时必须换工具。
量化交易Pine Script 入门:三行出一条均线,四条执行规则决定你写的对不对
写一个能在图上画出均线的指标,Pine Script 只需要三行,本文第一段就能直接粘贴运行。但真正决定你写出来的东西准不准的,是四条执行规则:脚本按每根 K 线执行一遍、所有变量都是序列、未收盘的那根 K 线会被反复重算、脚本跑在 TradingView 服务器上而不是你的电脑上。这篇给出三段可直接粘贴的完整代码(均线、放量金叉信号、策略骨架),讲透四条执行规则,并列出 Pine 做不到的五件事。
量化交易AI量化是不是骗局:六个骗局特征,四个自己就能做的验证
打着AI和大模型旗号的量化产品这两年特别多,其中真做量化的和纯粹套壳收钱的混在一起,光看宣传页分不出来。这篇不评价任何具体产品,只给判据:六个骗局产品身上高频出现的特征,每个都配一个你自己能核对的动作;再给四个动手验证的方法,包括逐笔记录抽查、小额实测、主体资质查询和资金权限检查。另附真做量化的团队通常长什么样。
觉得有用?关注公众号
扫码或在微信里搜「Tom讲交易」,每周更新交易教学文章
